ちょっと笑えない結果が出た。
小6の子どもが、初見の開成中過去問、2011年算数を実戦形式(60分)で解いた。
ただし今回は、解き始める前に一つ変なことをしていた。
ChatGPTに、
「この子が各設問を正解するかどうか、事前に予測してほしい」
と頼んでいた。
予測には、それまで蓄積してきた過去問演習(2012-2015)のログを使った。
単なる成績表ではない。
どの問題で止まったか。
最初に何を見たか。
どういう方針を立てたか。
どこで条件整理を間違えたか。
いつ総当たりに切り替えたか。
何分粘って飛ばしたか。
やり直したら解けたのか。
我が家では、こうした感想戦をかなり細かく残すことにしている。
そのログを読ませたうえで、2011年の問題に対する正誤を事前に予測させた。
結果は、
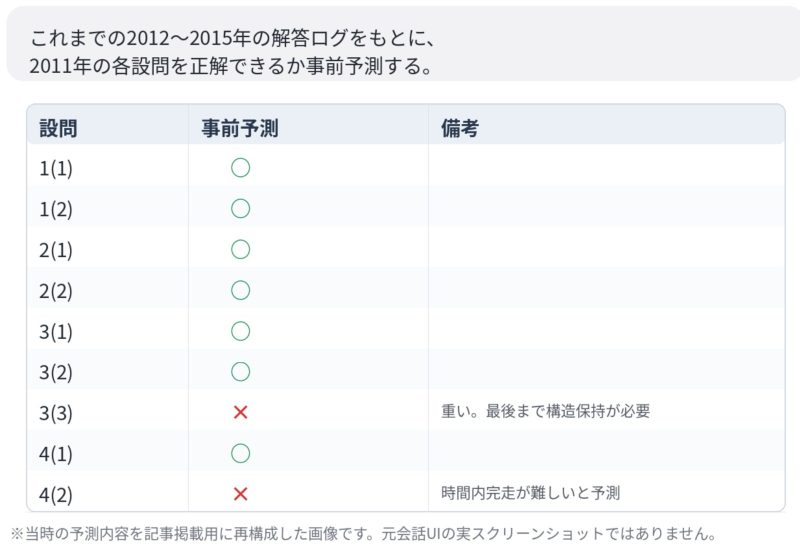
予測:7問正解、2問不正解。
そして結果も、
7問正解、2問不正解。
ここまでなら、
「だいたい実力帯を当てたんですね」
で済む。
問題は、その先だった。
不正解になると予測した2問まで一致した。
これが当時の予測内容である。
「7/9を当てた」だけではない
正直、最初に気持ち悪いと思ったのはここだった。
点数予測なら、それほど驚かなかったと思う。
過去の成績が十分にあれば、
「この年度ならこのくらい取るだろう」
という予測はできる。
しかし今回は違った。
AIは、
「ここは通る」
「ここは落とす」
を問題ごとに予測していた。
そして落とす場所まで一致した。
もちろん、これだけで何かが証明されたわけではない。
1年度、9設問だけである。
偶然かもしれない。
開成の問題構成に一定の傾向があり、過去のログと似た問題を拾っただけかもしれない。
AIの予測自体にも、かなり曖昧さがある。
だから、
「AIは子どもの思考を完全に理解した」
などと言う気はない。
むしろ、そう簡単に話が進んでもらっては困る。
正誤だけ当たったが、理由は外れていた
今回、そこも重要だった。
たとえば大問4のある設問は、AIの予測では「不正解」だった。
実際にも不正解だった。
ただし、AIが想定していた失敗の仕方と、本人が実際にしたミスは同じではなかった。
細かい話だが、子どもは時間切れで外したわけではない、大問3をスキップして大問4に取り掛かり、4(2)のYはあてたものの、Xを計算ミスで落とした。
つまり、
結果としての○×は当たった。
しかし失敗機序まで完全に読めていたわけではない。
これはかなり大事な区別だと思う。
後からいくらでも、
「ほら、この子はこういうタイプだから」
と説明を作ることはできる。
それでは意味がない。
だから今後は、
- 正解/不正解の予測
- その理由
- 想定される詰まり方
まで先に固定した方がいい。
予測が外れたら、そのまま残す。
次は2010年
そこで次の実験をすることにした。
開成2010年。
今回と同じように、解答前に予測を固定する。
そして本人が実際に解く。
終了後に比較する。
2010年で外れたら、それはそれでいい。
むしろ一度、きれいに壊れてくれた方が安心する。
2011年の一致は偶然だった。
その可能性が確認できるからだ。
逆に、2010年でも同じようなことが起きたら。
そのときは、
「AIが中学受験の点数を予測しました」
では済まなくなる。
もしかするとAIは、過去の行動ログから、
その人が未見の課題にどう反応するか
をある程度予測しているのかもしれない。
そう考えた瞬間、この話は中学受験から少し外れる。
そして、かなり気持ちが悪くなる。
次回は、その話を書く。
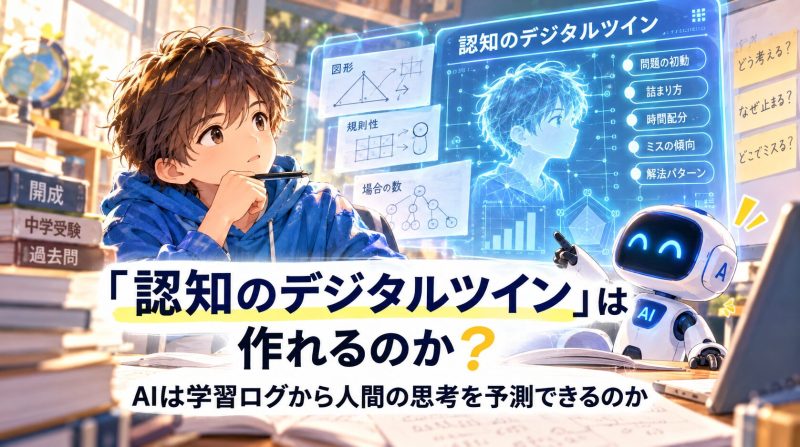
これは「認知のデジタルツイン」の入口なのか。
まだ答えは分からない。
今のところ言えるのは一つだけだ。
ちょっと笑えない。
コメント